[AI뭔데이-10] 숙련공 두 시간 시연, 하루 학습…카본식스, 휴머노이드 대신 공장 라인에서 피지컬 AI 승부

편집장의 말 & Pick

데이터

- 2026. 10. 6 -
AI 시대 데이터가 원유라는 말이 있습니다. 데이터 없이 차별화할 수 없다는 거죠. 그래서 지금 각 산업 현장은 우리가 가진 데이터가 무엇인지 파악하고 이걸 잘 모아서 저장하고 처리 가공하기 위해 분주합니다. 공장에 있는 기계는 물론 사람의 단순 반복 업무를 데이터화 하기 위해서도 마찬가지 움직임이 있습니다.

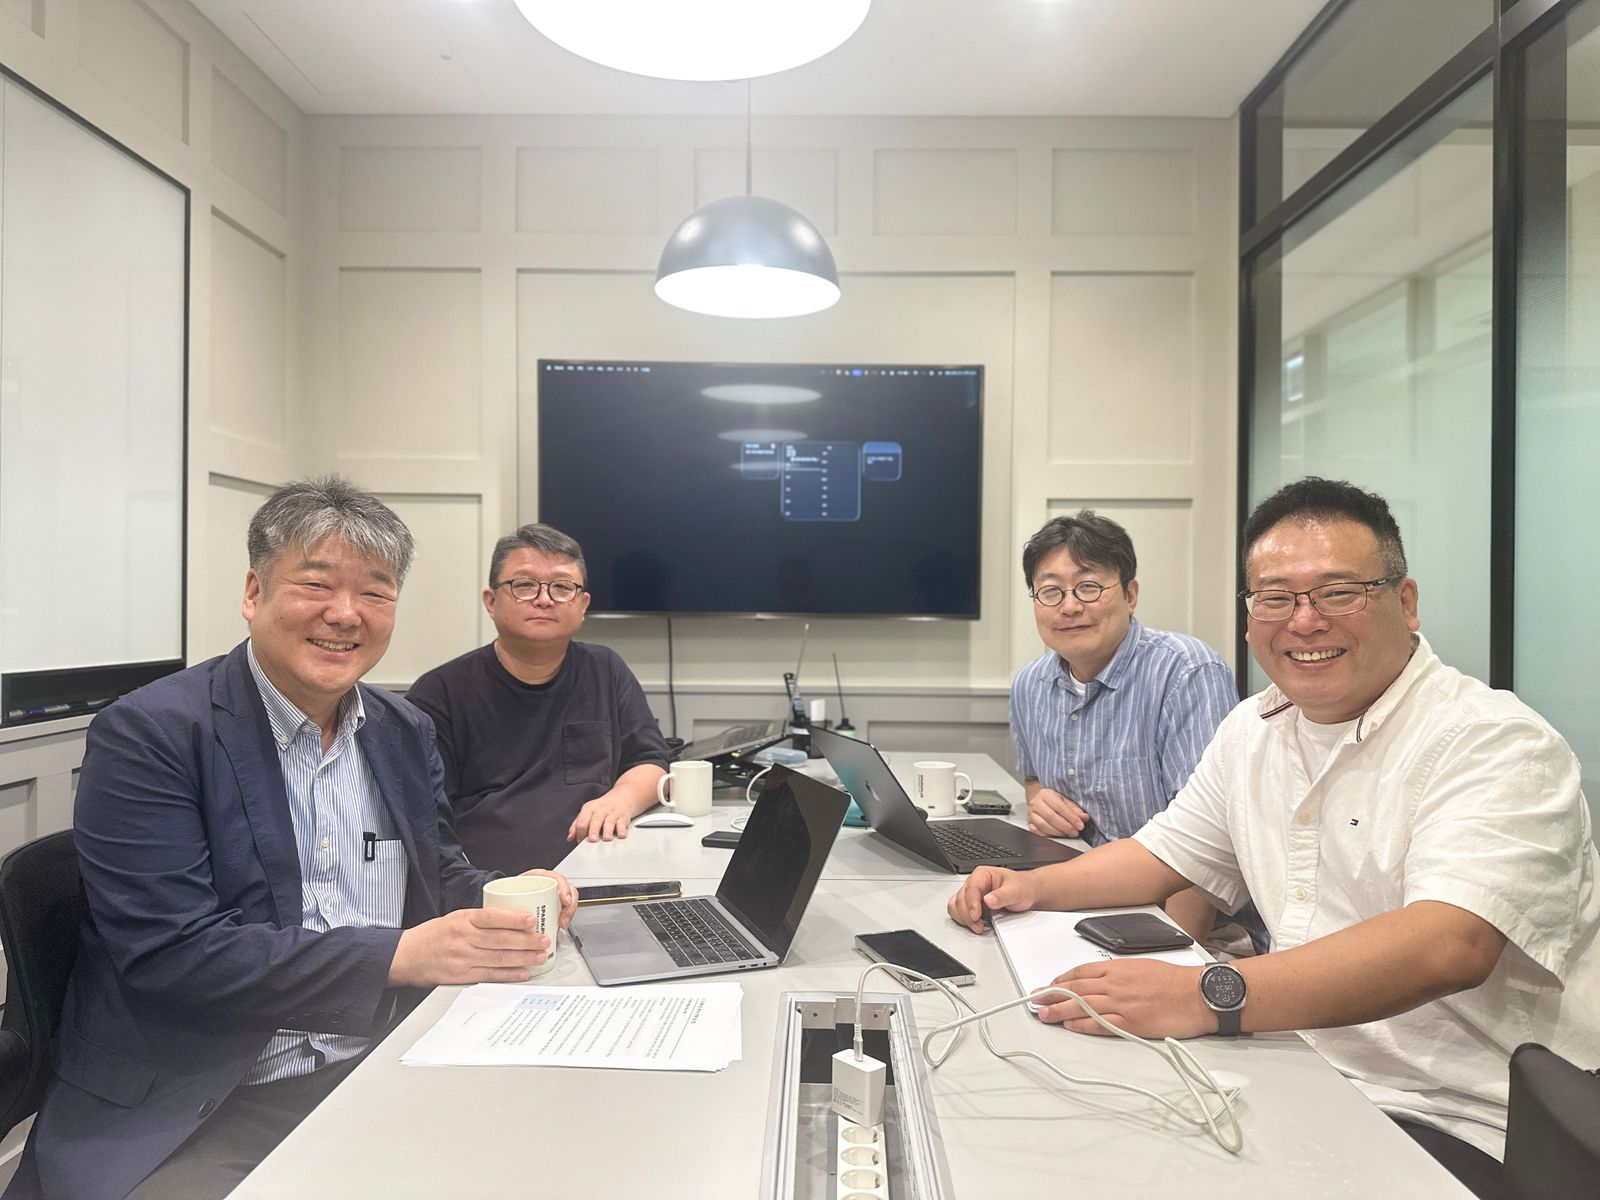
이번에 만난 카본식스는 전자 못지 않게 후자 영역에서도 활발히 움직이고 있습니다. 이 회사는 제조업 특화 피지컬AI 기업입니다. 브라운필드(Brownfield) 영역이죠. 부동산 용어였는데 피지컬AI 영역에서도 쓰이고 있습니다. 가동중인 생산라인에 로봇, 센서, AI를 추가하고 기존 시스템과 연결하는 거죠. 반대말은 그린필드(Greenfield)입니다. 설계 단계부터 AI와 로봇 중심으로 공정, 동선, 데이터 인프라를 구성합니다.

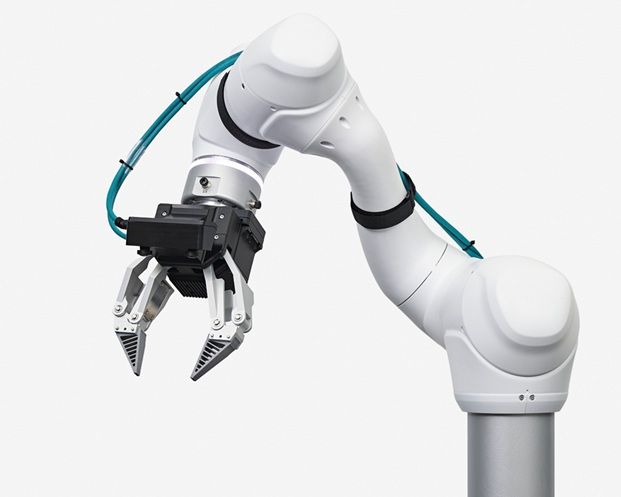
이 회사는 숙련공이 작업을 그대로 하는 동안 비전, 모션 데이터를 모으고, 자체 로봇 파운데이션 모델을 하루 동안 미세조정해 현장에 배치합니다. 특히나 케이블, 필름, 비닐처럼 기존 자동화가 손대지 못한 비정형 공정을 대상으로 합니다.

문태연 대표는 인공지능 머신비전 스타트업 수아랩(SUALAB)을 공동창업해 2019년 미국 코그넥스(Cognex)에 매각한 인물이더군요. 휴대폰 스크래치, 자동차 부품 필름 불량을 AI로 검사하며 10년 가까이 제조 현장에 AI를 적용해 왔습니다. 저 같으면 바로 편안한 삶을 누리고 있을텐데 이 분과 카본식스 구성원들은 세상의 문제를 풀기 위해 고군분투하고 있었습니다. 역시 젊은이들이 세상을 바꾸는 거 같습니다.

사람이 한 번 시연하면 바로 따라하는 모델을 지향하는 회사입니다. 많은 산업 현장에서 인력들은 점점 부족해지고 있기 때문에 이런 자동화 요구는 갈수록 늘고 있습니다. 문 대표는 베트남에도 출장이 잦다고 합니다. 며칠 전 베트남에서 일하는 지인과 통화를 하다보니 지금 베트남에 진출한 한국 기업들이 인력 확보에 비상이 걸렸다고 합니다.

중국 기업들과 ESG 때문이라고 합니다. 중국 기업들이 미국의 무역 전쟁을 회피하기 위해 베트남으로 공장을 이전하고 있습니다. 이들 기업들은 야근하고 싶으면 야근을 마음껏 할 수 있게 하나봅니다. 그러니 글로벌 룰을 따르는 한국 대기업과 협력사들은 야근을 무조건 시킬 수 없답니다. 그래서 한국 기업에서 일하던 베트남 노동자들이 중국 회사로 이직하면 야근 수당을 많이 챙길 수 있어서 다들 그리로 가고 있다고 합니다. 한국 기업들도 모두 자동화 이슈에 노출되어 있다고 합니다. 문태연 대표가 베트남에 자주 가는 이유도 비슷했습니다.

최근 이 영역에서 다시 주목받고 있는 용어가 '암묵지'입니다. 이걸 어떻게 데이터화해서 적용할지가 관건입니다. 카본식스가 조만간 실제 적용한 산업 현장에 초대하겠다고 했습니다. 그 기회를 얻을 수 있을지는 모르겠지만 참석하게 되면 나중에 또 자세히 알려드리겠습니다.

서울에는 일요일 살짝 비가 왔습니다. 기온도 뚝 떨어졌습니다. 이럴 때 일수록 건강 더 잘 챙기세요. 이번주는 아주 짧습니다. 가을 여행도 잘 즐기세요.

숙련공 두 시간 시연, 하루 학습…카본식스, 휴머노이드 대신 공장 라인에서 피지컬 AI 승부

숙련공 두 시간 시연, 하루 학습…카본식스, 휴머노이드 대신 공장 라인에서 피지컬 AI 승부

제조업 특화 피지컬 AI 기업 카본식스(CarbonSix)가 9월 22일 서울에서 기자들을 대상으로 '미디어 에듀케이션' 행사를 열고 로봇 지능의 발전사와 자사의 제조 현장 전략을 설명했다.

문태연 대표는 숙련공이 한두 시간 시연한 데이터로 하루 만에 로봇을 학습시켜 현장에 투입하는 방식을 소개했고, 서형주 최고기술책임자(CTO)는 모델 기반 제어에서 강화학습, 모방학습으로 이어진 로봇 연구 40년을 정리한 뒤 실제 공장 배치에서 데이터를 모으는 '데이터 플라이휠'을 회사의 비전으로 제시했다.

빨래 개기나 백덤블링 같은 시연 대신 케이블 체결, 필름 떼기, 대차 부품 꺼내기 같은 공장의 난공정을 정면으로 겨눴다.

⭐ 편집장 Pick
이주의 선택

오픈AI ChatGPT이 얼마 전 개발자 행사를 했습니다. 이 서비스가 등장한 후 지금까지 오픈AI는 무려 40개의 모델을 발표했다고 합니다. 오픈AI는 9월 3일 GPT-6 아스트라(Astra)에 이어 22일 GPT-6 솔(Sol)·루나(Luna), 29일 GPT-6.1 솔을 출시했습니다. 앤트로픽은 22일 클로드 오퍼스 5.5(Claude Opus 5.5)를 선보였고 이 대열에서 주춤하던 구글도 30일 제미나이 4 아르곤(Gemini 4 Argon)을 발표하면서 두 스타트업의 독주를 허락하지 않겠다는 입장입니다.

이들의 경쟁 속에서 중국 기업들은 오픈웨이트 모델을 선보였습니다. 오픈라우터(OpenRouter)가 공개한 자료에 따르면 2026년 8월 미국에서 발생해 자사 플랫폼으로 들어온 요청의 토큰 가운데 약 60%가 오픈웨이트 모델로 향했습니다. 오픈라우터는 중국 연구소의 모델이 해당 물량의 대부분을 차지한다고 설명했습니다. 이 통계는 오픈라우터 내부의 이용 현황이며, 미국 전체 AI 시장 점유율을 뜻하지 않습니다.

외부 기업들에 의존하던 마이크로소프트는 6월 개발자 행사인 빌드 2026에서 7개의 새로운 마이크로소프트 AI 모델을 발표했습니다. 그러면서 실제 업무를 처리할 때 비용 효율성을 들고 나왔습니다. 거대 모델은 거기에 맡는 일을 처리하도록 하고 그렇지 않은 업무의 경우 저렴한 비용이지만 성능이 떨어지지 않는 자사 모델을 적용하겠다는 뜻입니다.

기업들은 이제 실제 업무를 처리했는지 주목하고 있습니다. 엄청난 토큰을 썼지만 실제 맡긴 일을 끝냈다는 것이죠. 인프라 팀들은 어떤 모델들이 등장하는지 파악하는 동시에 여러 모델 중 업무별로 알맞는 걸 찾아서 적용해야 하는 능력을 갖춰야 하는 문제에 직면했습니다. 스위스 칼을 보는 거 같습니다.

쉼없이 달려가는 그들을 보면서 언제 멈추느냐고 말해봐야 소용이 없습니다. 이 치킨 게임은 멈추는 순간 죽고 그간 쌓은 노력은 다 물거품이 되기 때문입니다. 이들 경쟁 속에서 등장하는 성과물들을 내부에 적용하는 일은 생각보다 무척 어렵고 지난한 일입니다. 글로 끄적이는 저 같은 이들조차 따라가기 버거운데 여러분들은 오죽하시겠습니까.

1분기가 이전 테크 분야 1년 같습니다. 긴 호흡으로 대응하는 수밖에 달리 방도가 없어 보입니다. 그럼에도 불구하고 이들의 변화를 외면하는 순간 따라갈 수 없을 거 같은 공포도 있습니다. 공포 마케팅이가 싶기도 합니다.

4분기입니다. 한 해를 마무리하면서 동시에 새로운 해를 준비해야 합니다. 아마도 더 이상 이런 긴 계획이 의미가 없을지도 모릅니다. 그래도 어느 정도 방향을 마련해놔야 바로 바로 대응할 수 있을 거 같습니다. 2027년 예측 자료들도 많이 쏟아질텐데요. 너무 조찬 많이 가지 마세요. 큰 흐름이지 지금 바로 당장 적용하라는 건 아닙니다.

리더들의 역할이 더 중요해지는 시기입니다. 50대 중반인데 며칠 전 후배에게 저희 세대 욕을 엄청 먹었습니다. 왜 그런가 봤더니 권한을 가진 이들이 이런 변화를 적극 수용하지 않는다는 거였습니다. 과거 방식의 업무처리에 너무 매몰되어 있다는 거였죠. 일신우일신하고 스스로 이 변화에 몸을 던져야 하지 않을가 싶습니다. 다들 화이팅 ^.^

📅 이주의 행사
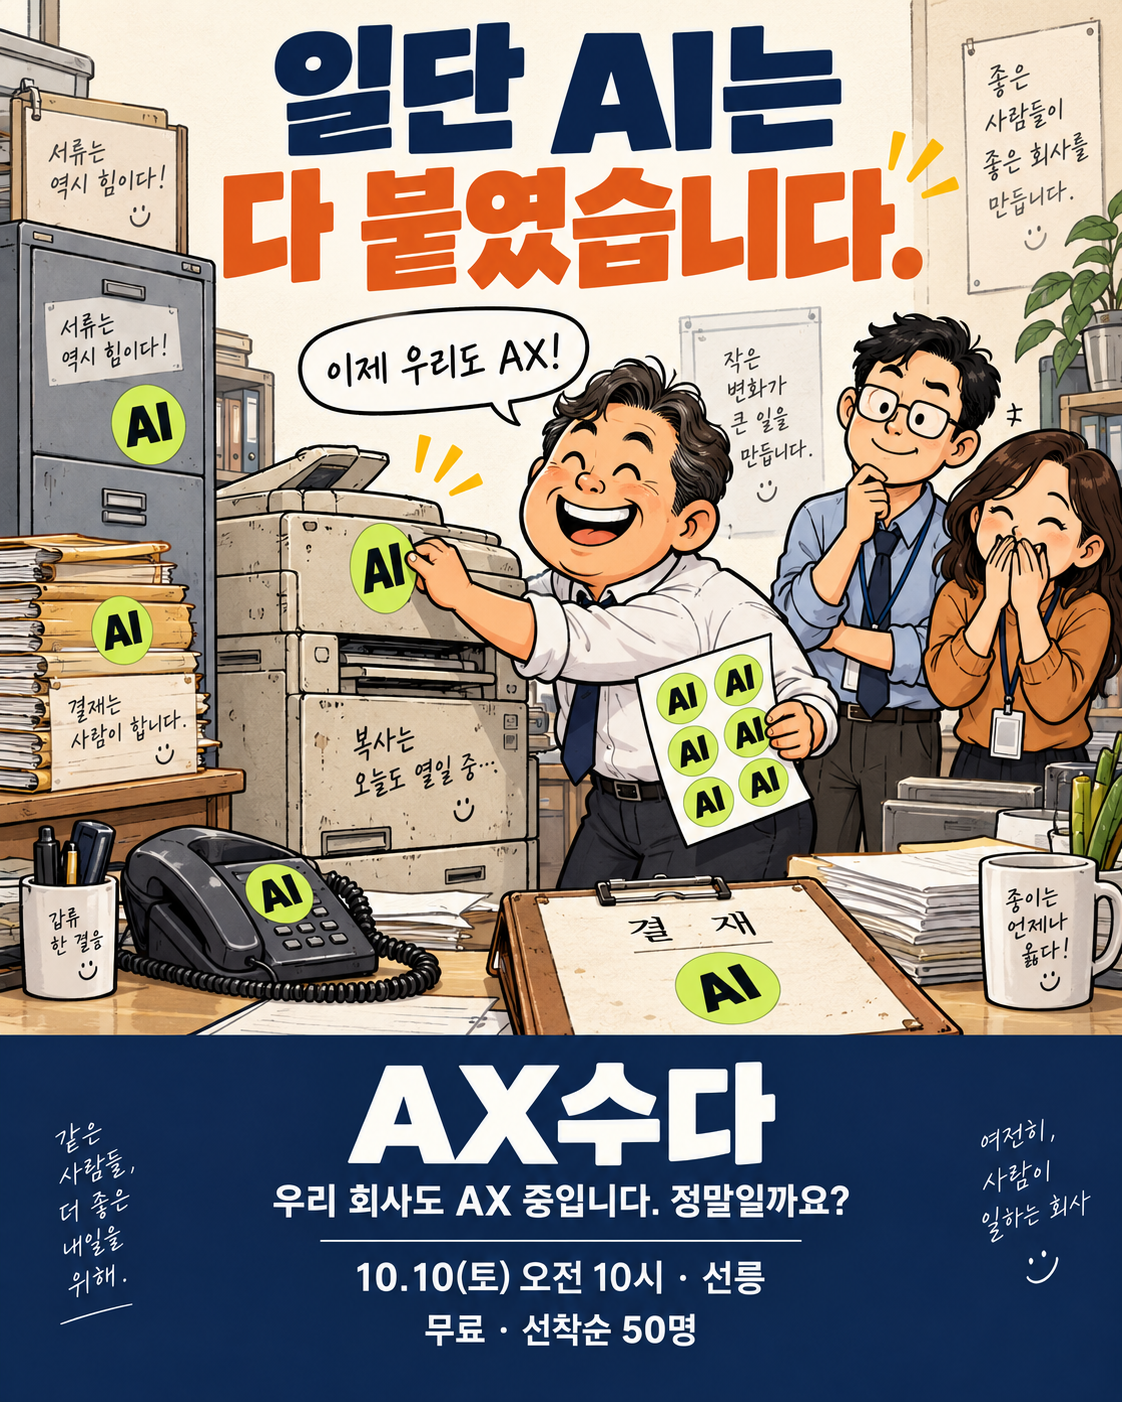
주최 테크수다 | 주관 테크수다비즈랩 | 2026.10.10(토) 10:00~12:30 · 패스트파이브 선릉센트럴점
AX수다
🔥 국내외 AI 핫기사
해외
국내
해외
📄 이주의 AI 논문
AI가 스스로 문제 내고 풀게 했더니, 둘이 같은 오답에 합의했다
False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents 럿거스대(Rutgers University)·맥길대(McGill University) 외 | 2026년 9월 30일 arXiv

사람이 만든 정답 데이터 없이 에이전트를 키우는 자기 진화(self-evolving) 방식이 확산되고 있습니다. 출제자 모델이 문서에서 문제와 정답을 만들고, 풀이자 모델이 그걸 풀며 배우고, 풀이자의 정답률에 따라 출제자가 다시 보상을 받는 순환 구조입니다. 그런데 이 고리 안에서 '맞혔다'는 판단은 오직 두 모델의 답이 일치하느냐로만 정해집니다.

연구진은 이 고리를 외부 판정 모델로 사후 감사했습니다. 학습 1라운드에 0.3~0.4%에 불과하던 '틀린 답에 대한 합의'가 3라운드에는 6.1~8.8%로 뛰었습니다. 내부 보상은 오르는데 실제 정답률은 제자리였습니다. 연구진은 이를 공모 부정행위(co-cheating)라 부릅니다. 의도적 담합이 아니라, 틀린 정답으로 배운 풀이자가 같은 출처의 다음 문제에서 그 오답을 되풀이하고, 그 일치가 다시 보상이 되는 구조 탓입니다.

해법인 크로스핏(CrossFit)은 단순합니다. 원본 문서를 A, B 두 묶음으로 나누고, A에서 나온 문제는 B로만 학습한 보조 풀이자가 채점합니다. 채점자가 그 출처의 오답을 배운 적이 없으니 같은 실수가 보상으로 돌아올 길이 끊깁니다.

틀린 합의는 3.0~3.7%로 절반 이하가 됐고, 7개 검색 벤치마크 평균 정확도는 기존 방식보다 8.4~8.8포인트 올랐습니다. 반면 같은 모델에 여섯 번 다시 물어 정답을 검증하는 방식은 연산 예산을 약 90% 늘리고도 개선 폭이 1포인트에 못 미쳤습니다. 정답을 더 꼼꼼히 확인하는 것보다 채점자가 무엇을 보고 배웠는지를 끊어주는 쪽이 훨씬 효과적이었다는 뜻입니다.

AI가 만든 데이터로 AI를 학습시키는 파이프라인을 운영한다면, 평가 모델의 학습 이력부터 분리해야 한다는 교훈입니다. 다만 실험은 40억·90억 파라미터의 소형 큐원(Qwen) 모델에 그쳤고, 감사 자체도 또 다른 AI 판정 모델에 기대고 있으며, 보조 풀이자를 따로 돌리는 데 예산이 70~80% 더 듭니다.

9월 둘째 주에 소개한 에이전트 담합 논문이 서로 다른 주인의 에이전트들이 속고 속이는 장면을 보여줬다면, 이번 논문은 한 시스템 안의 두 모델이 서로의 실수를 키우는 과정을 수치로 잡아냈습니다. 허깅페이스(Hugging Face) 데일리 페이퍼 주간 5위(392표).

<소스>
False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents (arXiv 2609.39102)

논문 보기 →
이 메일, 전달받으셨나요?
AI뭔데이를 매주 직접 받아보세요. 무료입니다.
무료로 구독하기
테크수다에 제보하거나 광고를 문의하고 싶으신가요?
언제든 아래 이메일로 연락 주세요.
테크수다 홈에서 더 보기 →

읽어주셔서 감사합니다.
다음 주, 새로운 AI뭔데이로 다시 찾아뵙겠습니다.

Newsletter
디지털 시대, 새로운 정보를 받아보세요!