.jpg)
앤트로픽, '클로드 오퍼스 5.5' 공개…페이블 5.1급 성능에 운영 비용 40% 절감
by
2026년 9월 23일
[테크수다 기자 도안구 eyeball@techsuda.com] 오픈AI(OpenAI)가 GPT-6 아스트라(GPT-6 Astra)에 이어 'GPT-6 솔(GPT-6 Sol)'과 'GPT-6 루나(GPT-6 Luna)'를 23일 출시했다. 업무의 복잡도와 규모, 요구 속도, 예산에 따라 이용자가 GPT-6 모델을 골라 쓸 수 있도록 선택지를 넓힌 것이다. 오픈AI에 따르면 두 모델은 아스트라와 비슷한 방식으로 학습해 전문 업무와 사실 정확성, 코딩, 컴퓨터 사용, 정렬 성능을 전 세대인 GPT-5.6 솔과 GPT-5.6 루나보다 끌어올렸다. 챗GPT 워크(ChatGPT Work)와 코덱스(Codex), API로 제공하며 API 가격은 전 세대 모델의 프로모션 가격보다 50% 낮췄다.
주요 내용:
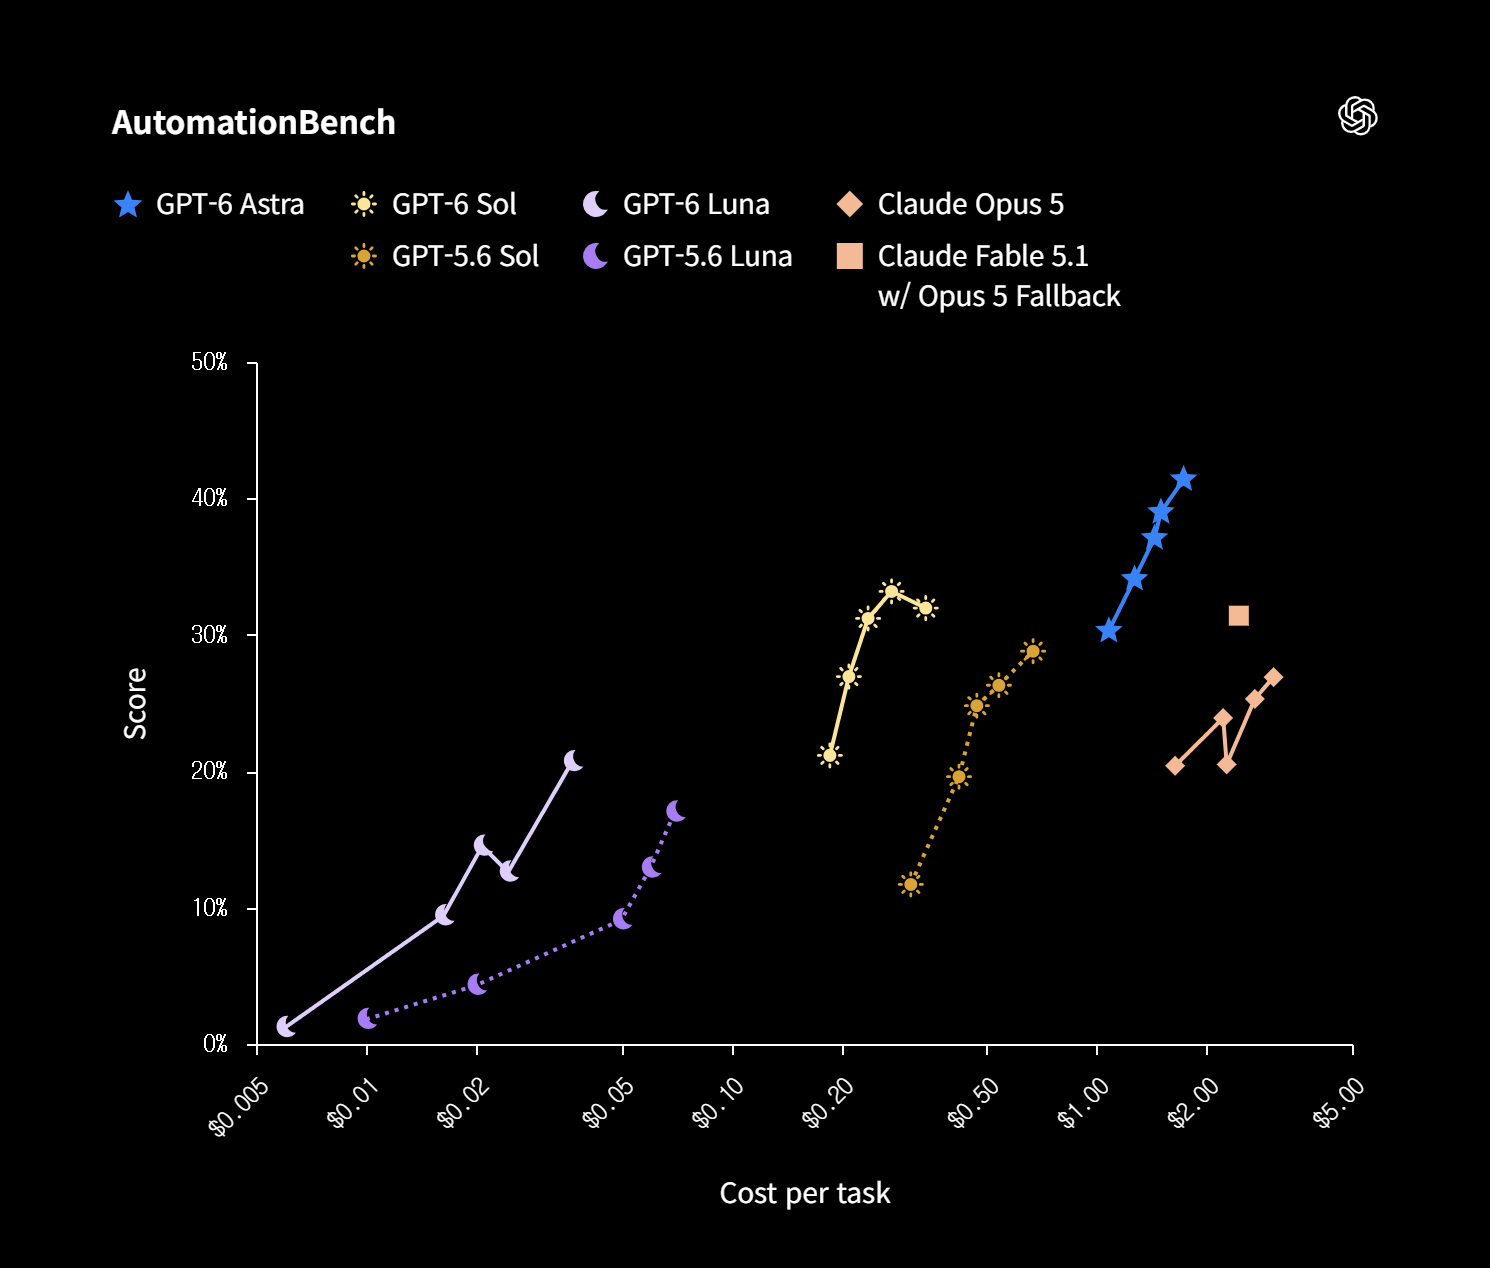
오토메이션벤치는 영업과 마케팅, 운영, 고객 지원, 재무, 인사 등 실제 업무 환경에서 47개 도구로 업무를 처음부터 끝까지 처리하는 능력을 평가한다. 오픈AI에 따르면 GPT-6 솔은 최상(xhigh) 추론 수준에서 33.2%를 기록해 GPT-6 아스트라의 낮음(low) 추론 수준 점수인 30.3%를 웃돌았다. GPT-6 루나는 높음(high) 추론 수준에서 GPT-5.6 루나보다 5.4%포인트 높은 점수를 냈고, 작업당 비용은 58% 낮았다. 이용자가 사실 오류를 지적한 실제 챗GPT 대화를 비식별화해 평가한 결과 GPT-6 솔의 오류는 GPT-5.6 솔의 약 절반에 그쳤다.
코딩 분야에서는 기술 대화의 전문용어와 어색한 표현, 불필요한 세부 설명을 줄여 핵심을 간결하게 전달하도록 다듬었다. 자신이 수행한 코딩 작업을 사실과 다르게 설명한 응답 비율도 GPT-6 솔 1.3%, GPT-6 루나 2.8%로 GPT-5.6 솔(10.4%)과 GPT-5.6 루나(9.5%)보다 크게 낮아졌다고 회사는 밝혔다. 개발자용 프롬프트 캐싱(prompt caching)은 기본 캐시 적중률을 높이고 캐시된 입력 토큰에 90% 할인 가격을 적용했다. 컴퓨터를 직접 조작해 여러 단계 업무를 수행하는 OS월드(OSWorld) 2.0 평가에서는 GPT-6 루나가 최대(max) 추론 수준으로 GPT-5.6 솔의 중간(medium) 추론 수준보다 높은 성능을 약 10분의 1 비용으로 기록했다.
GPT-6 솔과 루나는 플러스(Plus)와 프로(Pro), 비즈니스(Business), 엔터프라이즈(Enterprise), 에듀(Edu) 요금제 이용자에게 챗GPT 워크와 코덱스로 순차 제공된다. 무료와 고 요금제 이용자는 데스크톱 앱에서 GPT-6 루나를 쓸 수 있지만, 챗GPT의 일반 챗(Chat)에는 아직 적용하지 않았다. API 가격은 100만 토큰당 GPT-6 솔이 입력 2달러, 출력 10달러이고 GPT-6 루나는 입력 0.10달러, 출력 0.50달러다. 고성능이 필요한 중요 작업은 아스트라가, 일상 업무와 대규모 서비스는 솔과 루나가 맡는 구성으로 GPT-6 활용 범위를 넓히겠다는 것이 오픈AI의 구상이다.
Q. GPT-6 아스트라와 솔·루나는 어떻게 다른가요?
A. 아스트라는 높은 수준의 성능이 필요한 중요 작업을 위한 모델이다. 솔과 루나는 향상된 성능을 더 빠르고 비용 효율적으로 제공해 일상 업무와 서비스 전반에서 GPT-6를 쓰도록 설계했다. 이용자는 추론 수준을 조절해 복잡한 작업에서는 성능을, 간단한 작업에서는 속도와 비용 효율을 우선할 수 있다. 추론 수준은 모델이 문제 해결에 투입하는 추론 자원의 설정을 말한다.
Q. 사실 오류가 절반으로 줄었다는 수치를 일반 사용 환경에도 그대로 적용할 수 있나요?
A. 그렇지 않다. 오픈AI는 오류가 발생하기 쉬운 대화를 선별해 평가했으며, 이 결과가 일반적인 챗GPT 사용 환경의 오류 발생률을 뜻하지 않는다고 밝혔다. 코딩 작업 설명 정확성 평가 역시 사실과 다른 설명을 유도하도록 의도적으로 고른 어려운 작업을 대상으로 했다. 다만 같은 조건에서 GPT-6 루나는 높은 추론 수준에서 GPT-5.6 솔과 비슷한 정확성을 약 100분의 1 비용으로 기록했다.
Q. 개발자는 어떻게 이용하고, 비용 절감 효과는 어느 정도인가요?
A. API에서 GPT-6 솔은 'gpt-6-sol', GPT-6 루나는 'gpt-6-luna'라는 모델명으로 호출한다. 두 모델 가격은 각각 GPT-5.6 솔과 GPT-5.6 루나의 프로모션 가격보다 50% 낮다. 여기에 반복 입력 문맥을 재사용하는 프롬프트 캐싱을 개선해 캐시된 입력 토큰에는 90% 할인 가격을 적용한다. 깃허브(GitHub)는 최근 수개월간 이 개선으로 새로 처리해야 하는 프롬프트 토큰 비중이 50% 이상 줄었다고 밝혔다.
[테크수다 기자 도안구 eyeball@techsuda.com]
테크가 전 산업 영역에 스며드는 소식에 관심이 많다. 1999년 정보시대 PCWEEK 테크 전문지 기자로 입문한 후 월간 텔레닷컴, 인터넷 미디어 블로터닷넷 창간 멤버로 활동했다. 개발자 잡지 마이크로소프트웨어 편집장을 거쳐 테크수다를 창간해 지금까지 활동하고 있다. 태블릿을 가지고 얼굴이 꽉 찬 방송, 스마트폰을 활용한 현장 라이브를 한국 최초로 진행했다.