.jpg)
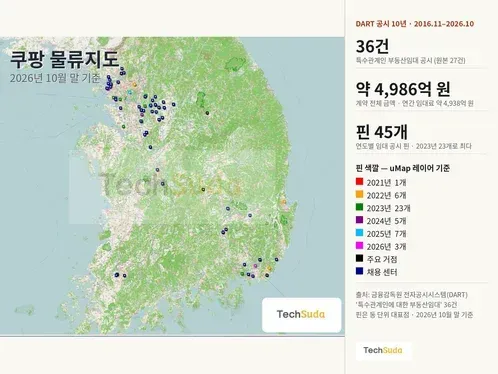
[AI뭔데이-15] 쿠팡 물류지도, 이렇게 만들었다…공시 36건과 무료 지도, 기획 하나
by
2026년 11월 9일
|
편집장의 말 & Pick
AI거품론??2026. 11. 16. 지난해 시월의 마지막날 경주가 떠올랐습니다. APEC 2025 경주 행사 중 CEO 서밋에 젠슨 황 엔비디아 창업자 겸 전 CEO가 참석했고 간담회가 있었습니다. 오늘 인사말을 무척 짧게 써야 할 거 같습니다. 그 때 상황을 글에 자세히 녹여놨기 때문입니다. AI 거품론부터 미중 무역 갈등, 이번 사태로 인해 한국, 대만, 싱가포르 등 나라마다 공이 어디로 튈지 몰라 당황스러운 상황입니다. 맨 마지막까지 읽어주십사 꼭 부탁드립니다. 행운의 부적 같은 걸 넣어놨거든요. | ||||||||
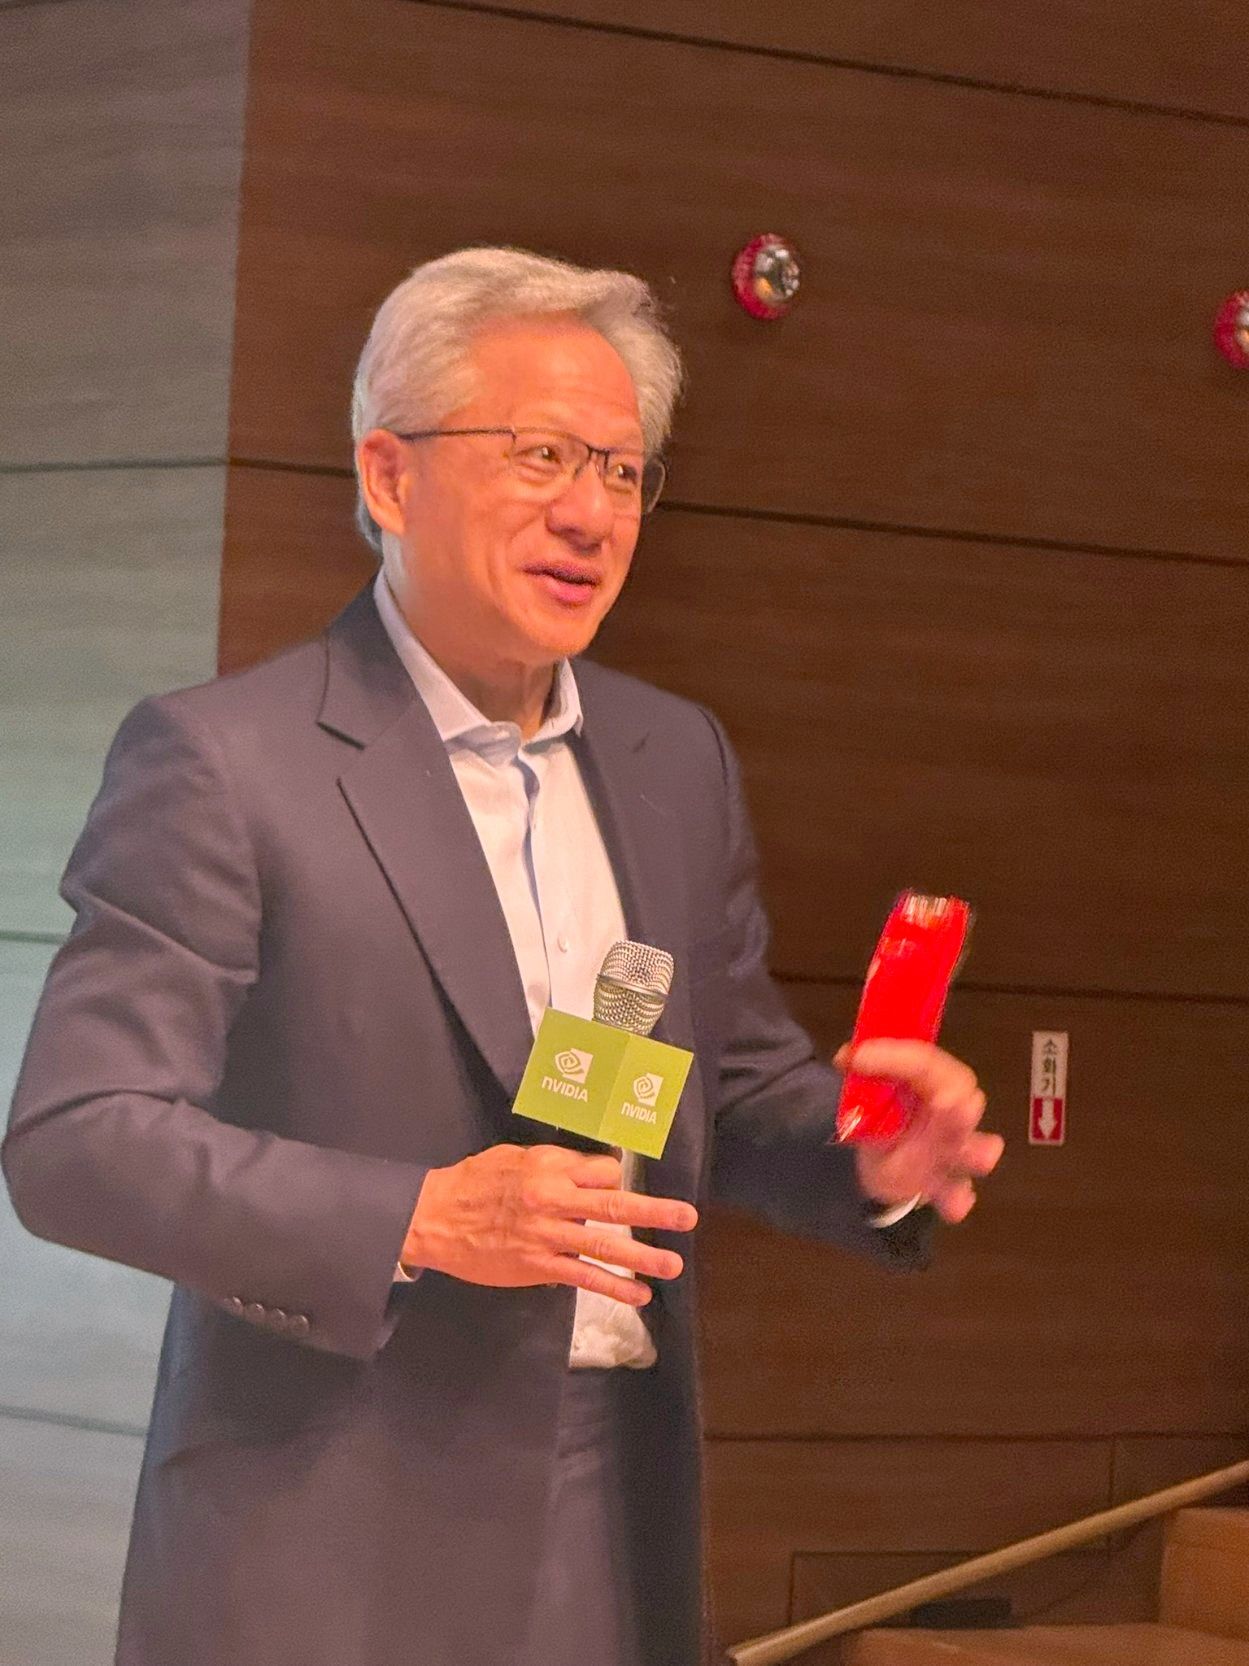
트럼프 대통령에게 블랙웰(Blackwell)의 중국 판매를 허용하도록 계속 로비할 생각인가?...APEC 2025 경주에서 미디어들이 던졌던 질문이 다시 생각났다.젠슨 황 당시 CEO는 "엔비디아가 AI 기술을 중국에 가져갈 수 있다는 것은 미국에도 중국에도 정말 좋은 일이라고 생각합니다. 이유는 여러 가지입니다. 하나는 물론 중국 시장이 크고 활력이 넘치는 시장이라는 점이고, 개발자가 많다는 점입니다. 그 개발자들이 만드는 AI 기술은 중국에서 전 세계로 수출됩니다. 그래서 미국의 기술 스택이 그런 AI 모델들을 구동하고 운영할 수 있는 한, 그것은 전 세계적으로 미국에도 좋은 일입니다"라고 답변했습니다. | ||||||||
|
⭐ 편집장 Pick
| ||||||||
| ||||||||
|
🔥 국내외 AI 핫기사
| ||||||||
| ||||||||
| ||||||||
|
📄 이주의 AI 논문
| ||||||||
| ||||||||
| ||||||||
|
테크수다에 제보하거나 광고를 문의하고 싶으신가요?
테크수다 홈에서 더 보기 →
언제든 아래 이메일로 연락 주세요. | ||||||||
|
읽어주셔서 감사합니다. |