.jpg)
[AI뭔데이-11] 화웨이, AI 페스타서 ‘AI 데이터센터 통째로’ 꺼냈다…NPU·스토리지·스위치 풀스택 공세
by
2026년 10월 12일
|
편집장의 말 & Pick
- 2026. 10. 19 - 에이수스(ASUS), 델(Dell), HP, 레노버(Lenovo), 마이크로소프트(Microsoft), MSI 등 6개 제조사가 윈도우(Windows) 기반 슬림 프리미엄 노트북으로 선보이며, 가격은 2,599달러부터다입니다. 생성형 AI 시대는 클라우드 사업자와 거대언어모델을 만들어 내는 스타트업들이 협력해 시장을 만들어 냈습니다. 개인들이 서비스를 무료 혹은 유료로 쓸 수 있었습니다. 여전히 이들의 협력은 긴밀하고 LLM 모델들이 새롭게 등장하면서 가장 먼저 클라우드 서비스 사업자들에게 얹어져서 고객들에게 제공됩니다. 엔비디아는 그 혜택을 가장 많이 본 회사입니다. 이번 행보는 개인 혹은 기업의 개발자들을 겨냥하고 있습니다. '온디바이스 AI'라고 해야 할까요? 개인들이 휴대하는 기기에 GPT-4 같은 초거대 모델과 별개로, 파라미터를 줄인 작은 소형 거대 언어 모델(sLLM : small LLM)을 기업 내부용 혹은 개인용으로 함께 사용할 수 있다는 것이죠. 메타 라마(LLaMa) 공개 이후 확산되었고 최근엔 중국의 많은 오픈웨이트 모델들이 등장하면서 더 주목을 받고 있습니다. 마이크로소프트는 2024년 5월 경 코파일럿+PC(Copilot+ PC)를 발표하며 NPU 성능 40 TOPS 이상(INT8 기준), 메모리 16GB와 저장 장치 256GB를 최소 사양이라고 제시했습니다. 당시 인텔이나 AMD가 AI PC라고 내세웠지만 그 성능을 못냈습니다. 오히려 이 기준을 맞춘 칩은 퀄컴의 스냅드래론 X 엘리트(약 45 TOPS) 뿐이었습니다. 물론 이후 인텔 루나레이크(48 TOPS)와 AMD 라이젠 AI 300(50 TOPS)이 2024년 하반기에 나오면서 두 회사가 뒤늦게 기준을 맞췄습니다. 이 시장에 엔비디아가 뛰어들었습니다. 이 회사는 최대 1페타플롭(1000 TFLOPS) 이라고 강조합니다. 물론 GPU의 수치라서 단순 비교는 불가능합니다. 하지만 40 TOPS 기준 대비 약 6배, 인텔과 AMD의 50 TOPS NPU 대비 5배 수준입니다. 128GB 통합 메모리는 코파일럿+PC 최소 사양인 16GB의 8배입니다. 이 제품은 'GPU와 대용량 메모리 이이전트와 LLM을 직접 돌리는 PC'에 가깝습니다. 지난 10월 8일 사티아 나델라 MS CEO와 젠슨 황 엔비디아 CEO가 함께 했습니다. AI 에이전트 격리 기술 MXC(Microsoft Execution Containers, MXC)를 에이전트 시대의 운영체제 기본 단위로 규정했죠. 두 CEO는 로컬 PC와 클라우드를 구분하지 않고 연산 자원을 쓰는 '하이브리드 인텔리전스'가 PC의 다음 장이라는 데 뜻을 모았습니다. MS는 같은 날 MXC를 윈도 11에 정식 출시하고, 엔비디아 RTX 스파크 기반 노트북 6종의 예약판매를 시작했습니다. AI PC로 대변되는 기업용과 개인용 생산성 도구의 경쟁이 본격화되고 있습니다. 애플 입장에서도 모처럼 마이크로소프트와 엔비디아의 연합군과 일대 격돌이 불가피할 것으로 보입니다. 윈텔 진영이 호령했던 개인용 시장은 여전히 막강합니다. 하지만 마이크로소프트 입장에서도 빌빌대는 인텔이나 AMD 이외에 엔비디아라는 막강한 우군을 맞이했습니다. 퀄컴이 윈도우용 PC나 노트북, 태블릿 시장을 겨냥하고 있는데 자리 잡기가 만만치 않을 거 같습니다. 생성형 AI 시대가 가져오는 새로운 협력과 경쟁의 모습입니다. 하지만 역시 지갑이 두터워야 합니다. 2599 달러부터 시작합니다. 시작이 그렇습니다. 이걸 지르는 회사와 개인들 보면 정말 부러울 거 같습니다. 서울에는 일요일 비가 내렸습니다. 쌀쌀합니다. 가을 단풍 구경도 못갔는데 겨울이 성큼 다가오려나 봅니다. 더 쌀쌀해지기 전에 가을을 꼭 만끽하시기 바랍니다. 좋은 한 주 보내세요. | ||||||||||
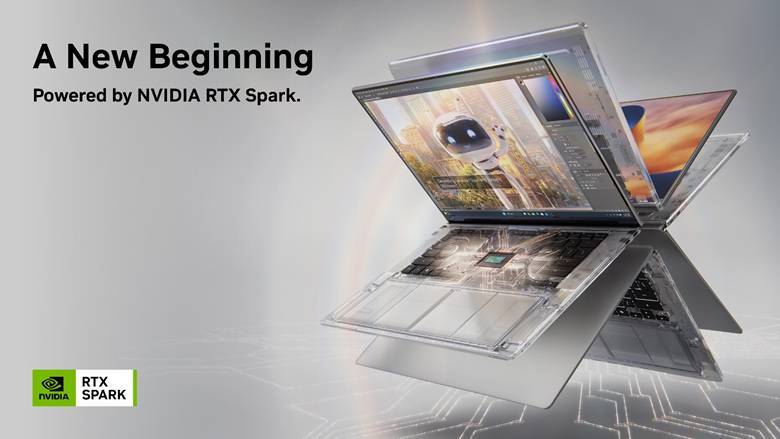
엔비디아, 'RTX 스파크' 노트북 출시… 128GB 통합 메모리·1페타플롭 AI 성능으로 PC에서 AI 에이전트 직접 구동엔비디아(NVIDIA)가 2026년 10월 16일(현지 시간) 블랙웰(Blackwell) RTX GPU와 그레이스(Grace) CPU를 하나로 묶은 슈퍼칩 기반 노트북 'RTX 스파크(RTX Spark)'를 출시했다. RTX 스파크는 최대 128GB 통합 메모리와 FP4 기준 최대 1페타플롭의 AI 성능을 갖춰 거대 언어 모델(LLM)과 AI 에이전트를 기기 안에서 직접 실행한다. 에이수스(ASUS), 델(Dell), HP, 레노버(Lenovo), 마이크로소프트(Microsoft), MSI 등 6개 제조사가 윈도우(Windows) 기반 슬림 프리미엄 노트북으로 선보이며, 가격은 2,599달러부터다. 엔비디아는 창작과 게이밍, 소프트웨어 개발, 로컬 AI 작업을 휴대용 PC 한 대로 처리할 수 있다고 설명했다. | ||||||||||
|
⭐ 편집장 Pick
| ||||||||||
| ||||||||||
|
🔥 국내외 AI 핫기사
| ||||||||||
| ||||||||||
|
📄 이주의 AI 논문
| ||||||||||
| ||||||||||
| ||||||||||
|
테크수다에 제보하거나 광고를 문의하고 싶으신가요?
테크수다 홈에서 더 보기 →
언제든 아래 이메일로 연락 주세요. | ||||||||||
|
읽어주셔서 감사합니다. |